“로봇이 넘어져도 데이터가 된다”…중국, 하루 2.4만건 쌓으며 ‘피지컬AI’ 속도전
우한 휴머노이드센터, 실패·오류까지 학습 데이터로 축적…실제 환경 반복 훈련
중국, 상용 로봇 AI 데이터 약 90% 확보 추정…하드웨어 넘어 ‘로봇 두뇌’ 경쟁 본격화
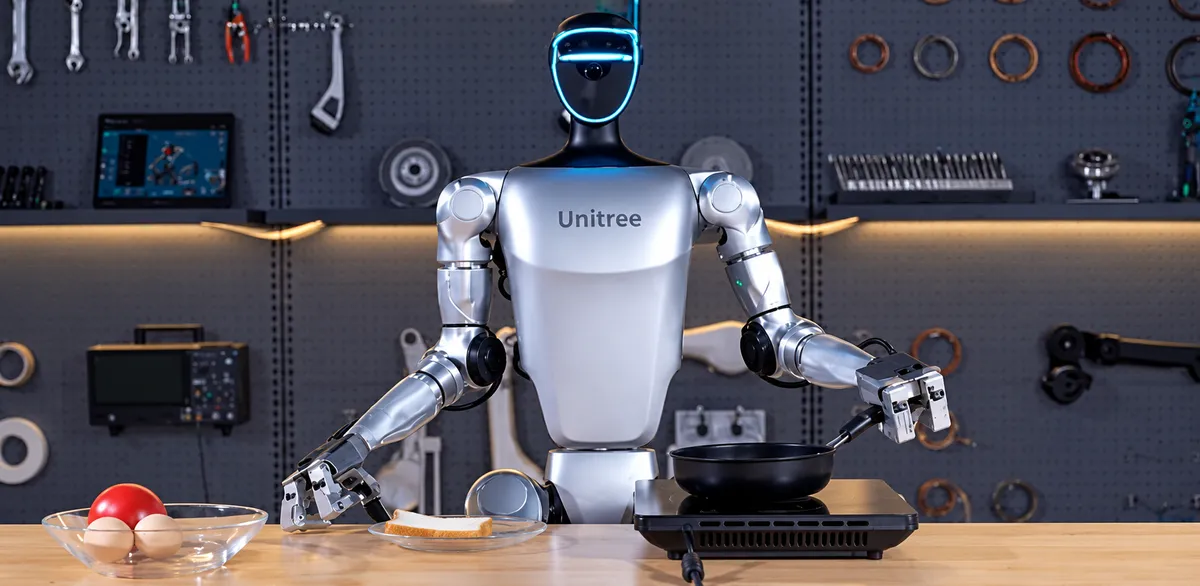
춤추다 넘어지고 차를 따르다 테이블에 쏟는 로봇의 실수까지 인공지능(AI)을 고도화하는 자산으로 활용하는 중국의 ‘데이터 축적 전략’이 주목받고 있다. 휴머노이드 로봇 경쟁의 중심이 하드웨어에서 실제 환경을 이해하고 행동하는 ‘피지컬AI’로 이동하면서 중국이 대규모 로봇 훈련센터와 풍부한 실증 환경을 앞세워 데이터 확보에 속도를 내고 있다.
중국 후베이성 우한의 휴머노이드 로봇 혁신센터는 총면적 1만2000㎡ 규모로 조성된 대형 로봇 실증·훈련 거점이다. 슈퍼마켓과 카페, 생산라인, 창고, 주거공간 등 실제 생활·산업현장을 모사한 환경에서 로봇의 이동과 물체 인식, 집기, 운반 등의 행동 데이터를 수집한다.
우한 센터에서 생산되는 훈련 데이터는 하루 약 2만4000건에 달한다. 수집된 데이터는 검수와 정제 과정을 거쳐 로봇 AI 모델 학습에 활용된다.
성공만큼 중요한 ‘실패 데이터’…로봇도 실수하며 배운다
로봇 AI가 대규모언어모델(LLM)과 다른 점은 실제 물리세계에서 움직이며 얻는 데이터가 중요하다는 것이다. 인터넷에 존재하는 텍스트와 이미지만으로는 실제 공간에서 물체를 잡고 이동하거나 예상하지 못한 상황에 대응하는 능력을 충분히 학습하기 어렵다.
이 때문에 중국에서는 로봇이 넘어지거나 물체를 잘못 잡고, 컵 위치를 인식하지 못해 음료를 쏟는 과정도 학습 가치가 있는 데이터로 활용한다.
성공한 움직임뿐 아니라 실패 원인과 수정 과정까지 학습해야 로봇이 다양한 환경에 대응하고 스스로 행동을 개선하는 능력을 갖출 수 있다는 판단이다.
중국 정부는 이런 실증 데이터를 확보하기 위해 전국적으로 휴머노이드 로봇 관련 인프라를 확대하고 있다. 올해 상반기 기준 성급 이상 휴머노이드 로봇 혁신센터는 22곳이며, 데이터 수집센터도 전국에서 최소 90곳이 운영되거나 건설·계획 단계에 있다.
중국은 2026년 말까지 휴머노이드 로봇 분야에서 100개 이상의 고부가가치 응용 시나리오와 만 대 규모의 현장 배치 능력을 확보한다는 목표도 제시했다.
중국 상용 로봇 AI 데이터 비중 ‘90%’ 추정
중국이 데이터 확보에 속도를 내는 배경에는 로봇 산업의 경쟁력이 하드웨어에서 AI 학습능력으로 이동하고 있다는 판단이 깔려 있다.
로봇이 실제 공간에서 사람처럼 움직이려면 물체의 크기와 위치, 힘 조절, 이동 경로, 돌발 상황 등 현실세계에서 발생하는 방대한 정보를 학습해야 한다. 특히 시각·언어·행동을 결합한 VLA 모델이 고도화되기 위해서는 실제 로봇의 반복적인 행동 데이터가 필요하다.
미국 데이터라벨링 기업 스케일AI에 따르면 상업적으로 이용 가능한 로봇 AI 데이터 가운데 중국이 차지하는 비중은 약 90%로 추정되며, 데이터 생산 비용도 미국보다 약 60% 낮은 것으로 분석됐다.
중국의 대규모 제조 기반과 상대적으로 낮은 데이터 생산비, 정부 지원을 받는 실증센터가 결합되면서 대량의 로봇 행동 데이터를 빠르게 축적할 수 있는 환경이 조성된 것이다.
다만 속도전의 부작용도 나타나고 있다. 지방정부와 기업들이 경쟁적으로 훈련센터를 구축하면서 실제 데이터 구매 수요와 상업화가 투자 속도를 따라가지 못할 수 있다는 과잉투자 우려도 제기된다.
일부 센터에서는 데이터 품질이나 판매수익 문제로 협력 계약이 중단되는 사례도 나오고 있어 단순히 데이터를 많이 확보하는 것에서 나아가 품질과 활용도를 높이는 것이 다음 과제로 꼽힌다.
결국 휴머노이드 로봇 경쟁의 승부처는 ‘얼마나 멋지게 움직이느냐’보다 얼마나 많은 현실 데이터를 확보하고 이를 로봇의 지능과 행동 능력으로 전환하느냐에 달릴 가능성이 크다. 중국이 축적하고 있는 성공과 실패 데이터가 범용 휴머노이드의 ‘챗GPT 모멘트’를 앞당길 수 있을지, 대규모 정부 지원이 실제 산업 현장의 수요와 사업화로 이어질지가 향후 피지컬AI 시장의 핵심 관전 포인트다.